DeepSeek vient de lâcher un prototype d'agent qui vit dans un repo GitHub. Ce n'est pas un énième bot qui patche en boucle, et c'est justement pour ça que ça mérite qu'on s'y arrête.
Non, ce n'est pas un bot qui patche votre repo tout seul
Le 31 octobre, l'équipe Harness de DeepSeek a publié dsh-superagent-prototype, sous licence MIT.
Quand j'ai vu passer le repo, j'ai d'abord cru à un watcher qui corrige le code dès qu'une guideline est violée.
Ce n'est pas ça.
L'agent écoute GitHub (et Feishu en option), mais il n'agit que dans deux cas :
- quelqu'un d'autorisé lui demande du travail
- une règle écrite par l'équipe l'autorise à agir
Et même là, le travail que personne n'a demandé démarre en mode observation : l'agent note ce qu'il aurait fait, sans rien toucher.
Le principe affiché dans le README est simple : prendre le moins d'attention humaine possible pour rendre le maximum de valeur.
Mais la vraie dinguerie, c'est l'architecture
Le point de départ de DeepSeek, c'est un constat que tous ceux qui codent avec des agents connaissent : on arrive à suivre 3 à 5 sessions actives, pas plus.
Donc le plafond n'est plus le modèle. C'est votre cerveau.
Lancer dix agents en parallèle ne sert à rien si vous passez votre journée à jongler entre dix terminaux. Leur réponse, c'est de couper le système en deux couches :
- un Router, qui parle aux humains et distribue le travail, mais qui ne code jamais
- des Workers isolés, chacun dans sa session et son dossier, qui bossent en parallèle
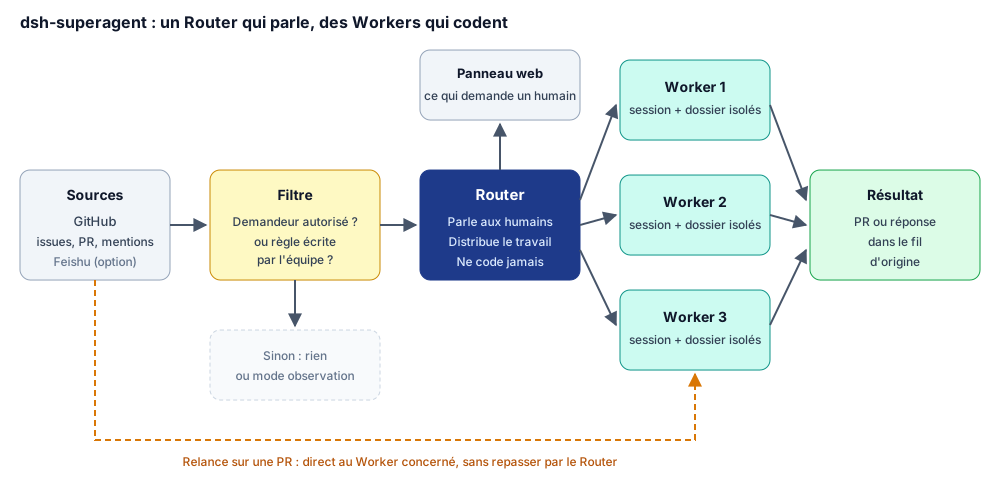
Et quand vous relancez sur une PR, le message part directement au Worker concerné, sans repasser par le Router.
Le Router n'a même pas forcément besoin d'un shell, et un modèle léger lui suffit souvent. C'est exactement le genre de rôle où un modèle type V4.1-Flash (que j'utilise déjà en prod) a tout son sens, pendant que les Workers tournent sur le modèle le plus costaud.
Ce que je trouve malin : le Router ne peut pas faire le travail lui-même. Donc le modèle n'a plus à décider s'il délègue ou non.
Car c'est là que ça coince aujourd'hui. Dans les tests de DeepSeek, une session unique équipée d'un outil de sous-agents n'a jamais délégué avec un prompt neutre. Résultat au p95 : 29,5 minutes par demande, contre 15,7 pour le Super-agent.
Mais attention : ces chiffres sont auto-déclarés, sur un flux synthétique d'environ 300 messages, et le code y était remplacé par un outil qui se contente de consommer du temps. On mesure l'orchestration, pas la qualité du code produit.
Et donc, c'est juste un Copilot open source ?
Sur le flux visible, je ne vais pas vous mentir : ça y ressemble beaucoup.
Une issue arrive, un agent bosse dans son coin, une PR sort, on itère en commentaire. Le coding agent de GitHub Copilot fait déjà ça.
Mais la différence n'est pas dans la boucle issue → PR :
- Copilot attend qu'on lui assigne une tâche, le Super-agent peut agir sur une règle écrite par l'équipe
- chez Copilot, chaque issue est un job isolé, ici un Router unique fait le lien entre le chat et GitHub
- Copilot est propriétaire et hébergé chez GitHub, ici c'est du MIT qui tourne sur votre machine, avec votre modèle
- le design entier est pensé pour filtrer ce qui mérite votre attention, pas seulement pour produire des PR
Et ce troisième point compte plus qu'il n'y paraît. Des Workers sur un modèle bon marché, c'est le coût par tâche qui change, pas juste le prix au token.
La vérité, c'est qu'en tant que produit utilisable aujourd'hui, l'écart avec Copilot est mince (et le prototype est même moins fiable). Ce qui est inédit, c'est qu'un acteur de ce calibre publie en open source le design d'orchestration que les autres gardent fermé.
Donc, ça va vraiment libérer du temps aux devs ?
Potentiellement, oui. Mais pas demain matin.
Le repo coche à peu près toutes les cases du "ne mettez pas ça en prod" :
- prototype de recherche, pas un produit officiel DeepSeek, différent de leur version interne
- un seul repo GitHub géré
- l'agent exécute des commandes sans approbation sous votre utilisateur (DeepSeek recommande un compte système dédié)
- il repose sur DeepSeek Harness, encore en developer preview
- les premiers retours terrain remontent déjà des bugs dès la première heure (service introuvable sous Node 24, mentions GitHub perdues)
Je ne l'ai pas encore fait tourner sur un vrai repo, donc je me garde bien de crier au génie sur l'implémentation.
Au final, le gain de temps promis ne vient pas d'un agent qui code à votre place. Il vient d'un agent qui ne vous dérange que quand c'est utile.
Et si l'attention devient la ressource rare d'une équipe tech, la vraie question devient : combien d'agents un dev senior est-il capable de piloter avant de devenir lui-même le bottleneck ?