Si les modèles sont si bons en chat depuis des années, pourquoi l'automatisation réelle reste-t-elle aussi laborieuse ?
C'est la question que pose Diogo Almeida (passé par OpenAI, où il a travaillé sur les méthodes d'instruction following à l'origine de ChatGPT).
Sa boîte, TypeSafe AI, sort de 2 ans de stealth avec une nouvelle classe de modèles baptisée System One Models (clin d'œil au Système 1 de Kahneman).
Et leur premier modèle, Jev, fait un choix radical : il abandonne purement et simplement la génération de texte.
Vous lui donnez un état non structuré, il vous rend des décisions typées, définies à l'avance dans un schéma, chacune accompagnée d'une probabilité calibrée.
Donc pas de parsing, pas de JSON bancal à valider, pas de modèle qui part en freestyle au milieu d'un pipeline.
Sur le papier, les chiffres annoncés sont délirants :
- une latence de 70 à 500 ms de bout en bout
- 0,042 $ par million de tokens en entrée, et des tokens de sortie gratuits
- jusqu'à 193,6 fois plus rapide et 444,6 fois moins cher sur leurs évals de workflows
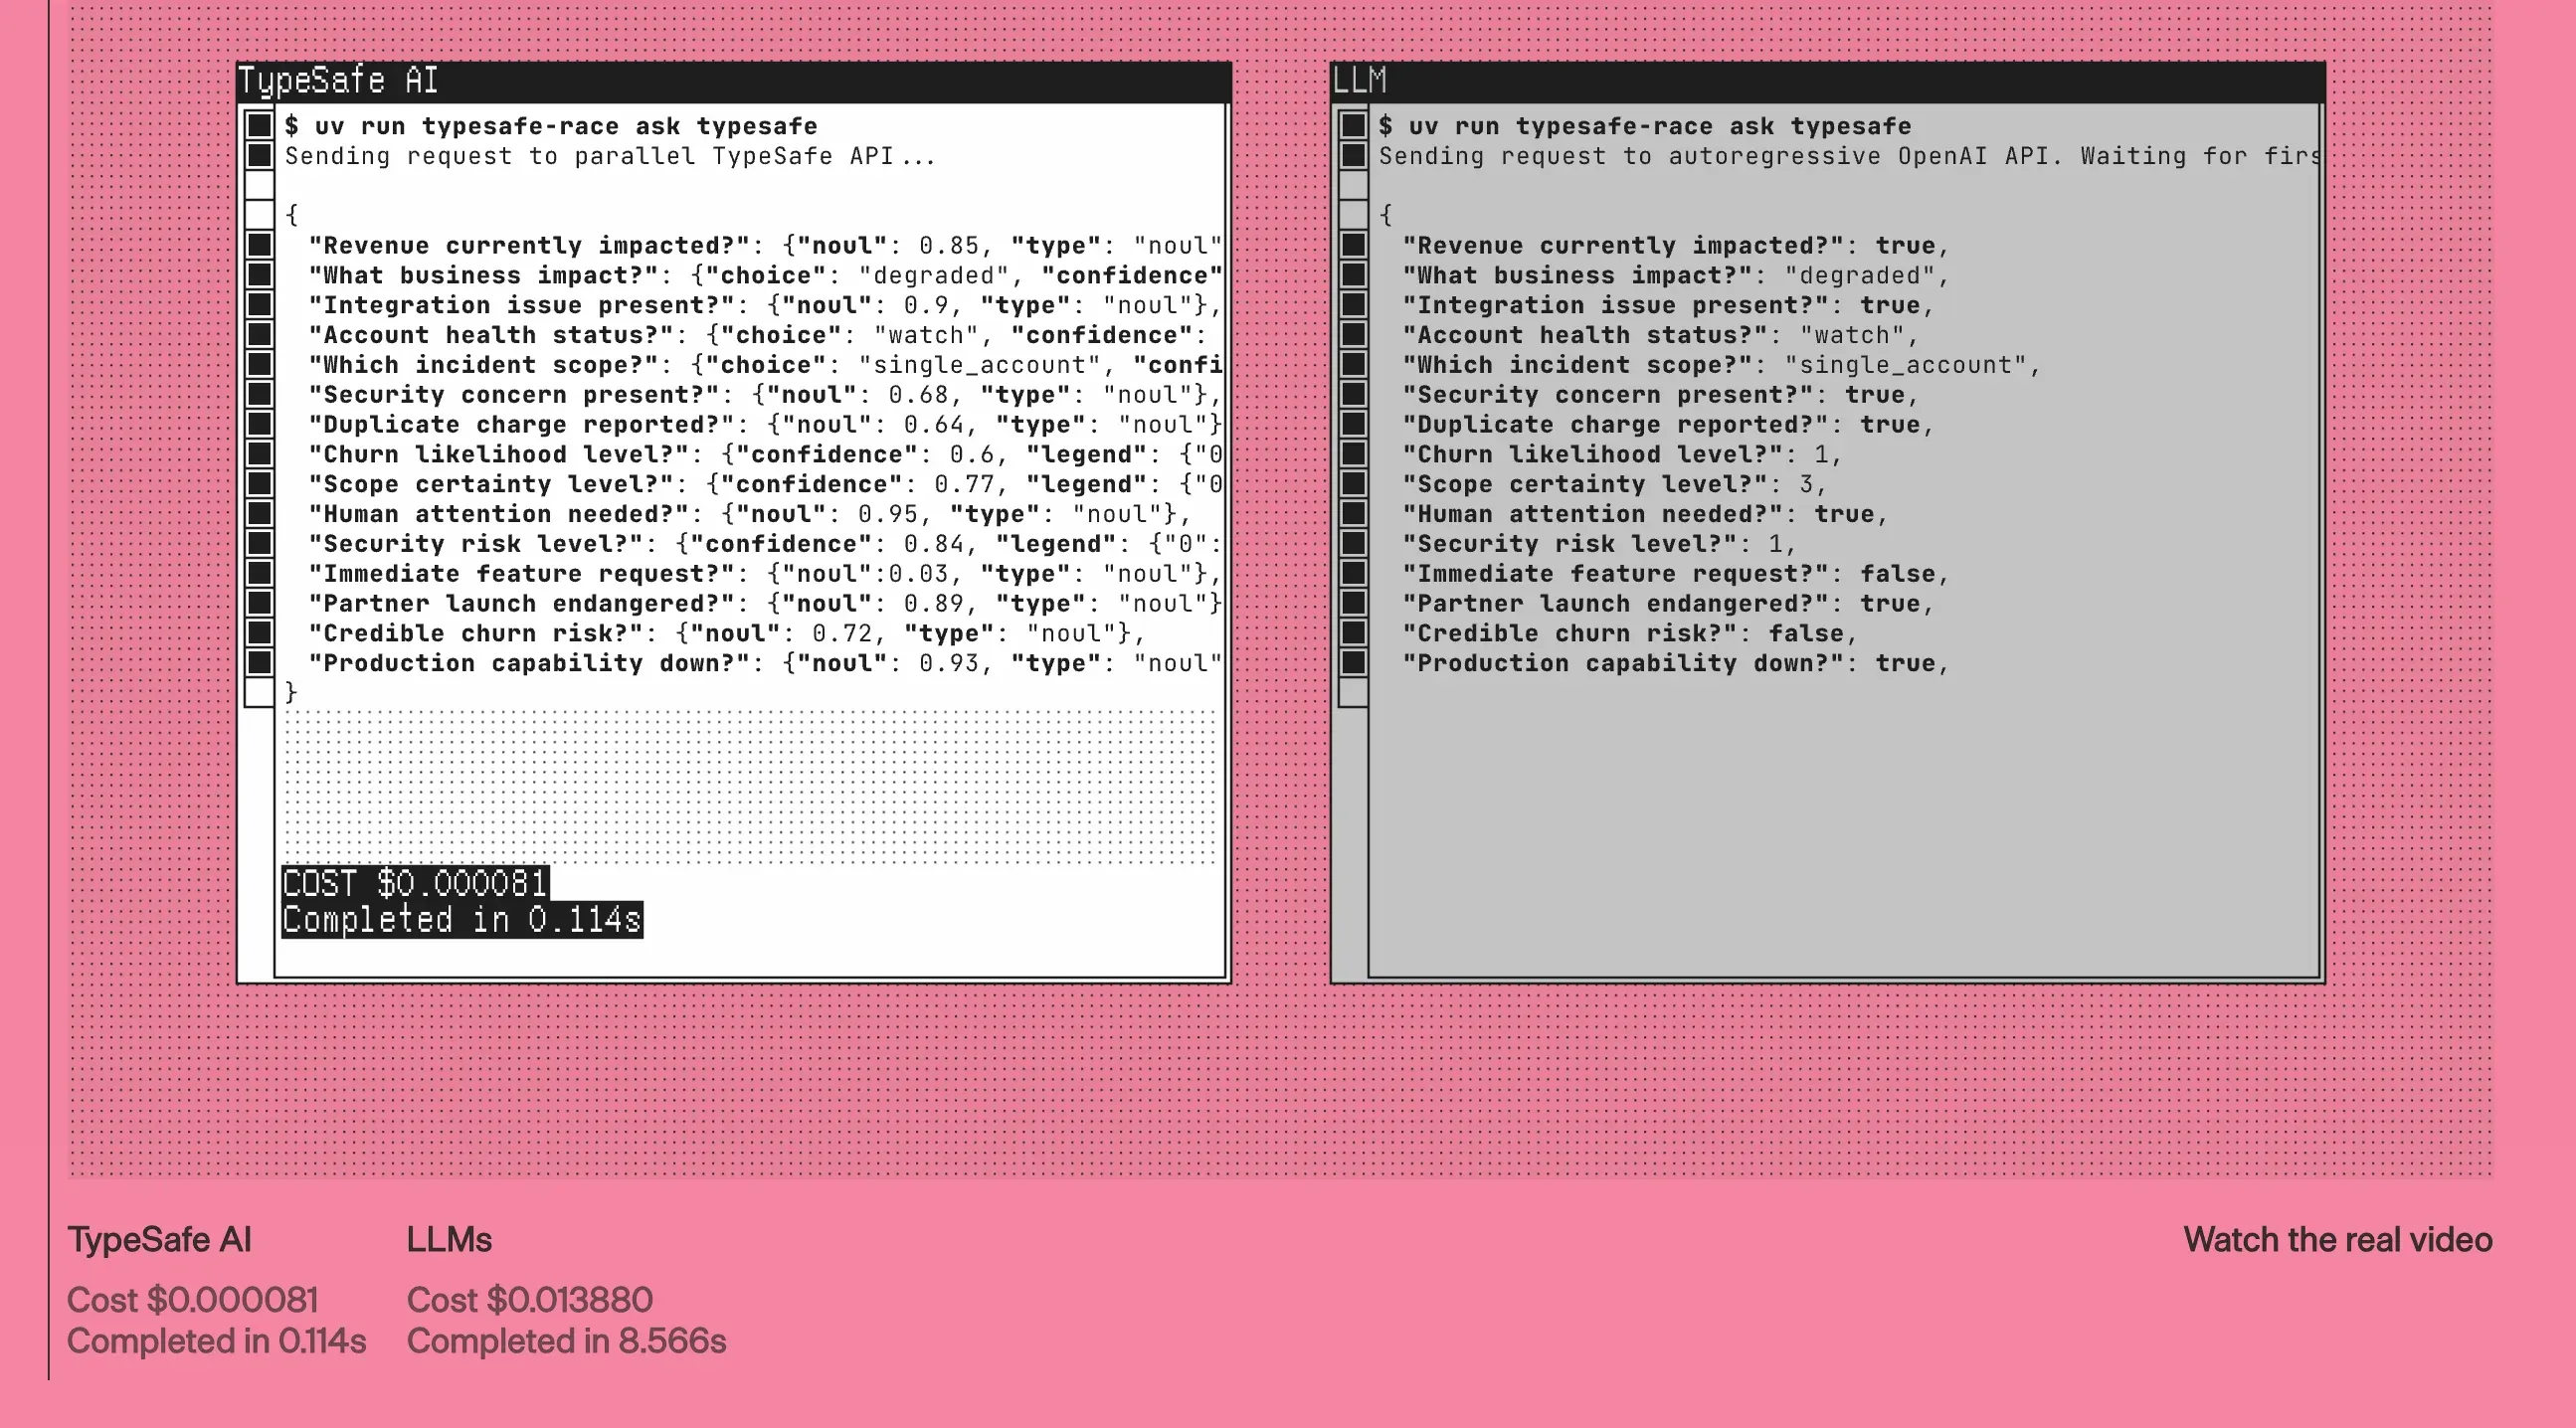
Mais tout ça est auto-déclaré, et TypeSafe a l'honnêteté (assez rare pour être notée) de lister elle-même les biais : les évals ont été construites par leur propre équipe, la référence est la moyenne de GPT-6 Astra et Fable 5.1, ils présentent eux-mêmes ces gains comme le haut de la fourchette, et ils admettent ne pas pouvoir prouver que leur prix n'est pas subventionné.
Et le fameux "ne peut pas halluciner" mérite d'être lu correctement : ce qui est garanti, c'est que la sortie respecte le schéma (leur 0 % n'est pas mesuré, il découle mécaniquement de la contrainte). Un modèle peut parfaitement choisir la mauvaise branche avec une sortie impeccablement typée. La vraie promesse est ailleurs : dire quand il n'est pas sûr, ce que les LLM actuels font très mal.
Je n'ai pas encore testé Jev (c'est en accès anticipé, sur waitlist), donc je ne vais pas vous vendre une révolution.
Mais le positionnement me parle.
Je m'explique : dans un workflow d'automatisation, une bonne partie des appels LLM sont en réalité des if intelligents (classer un ticket, router une demande, scorer un lead).
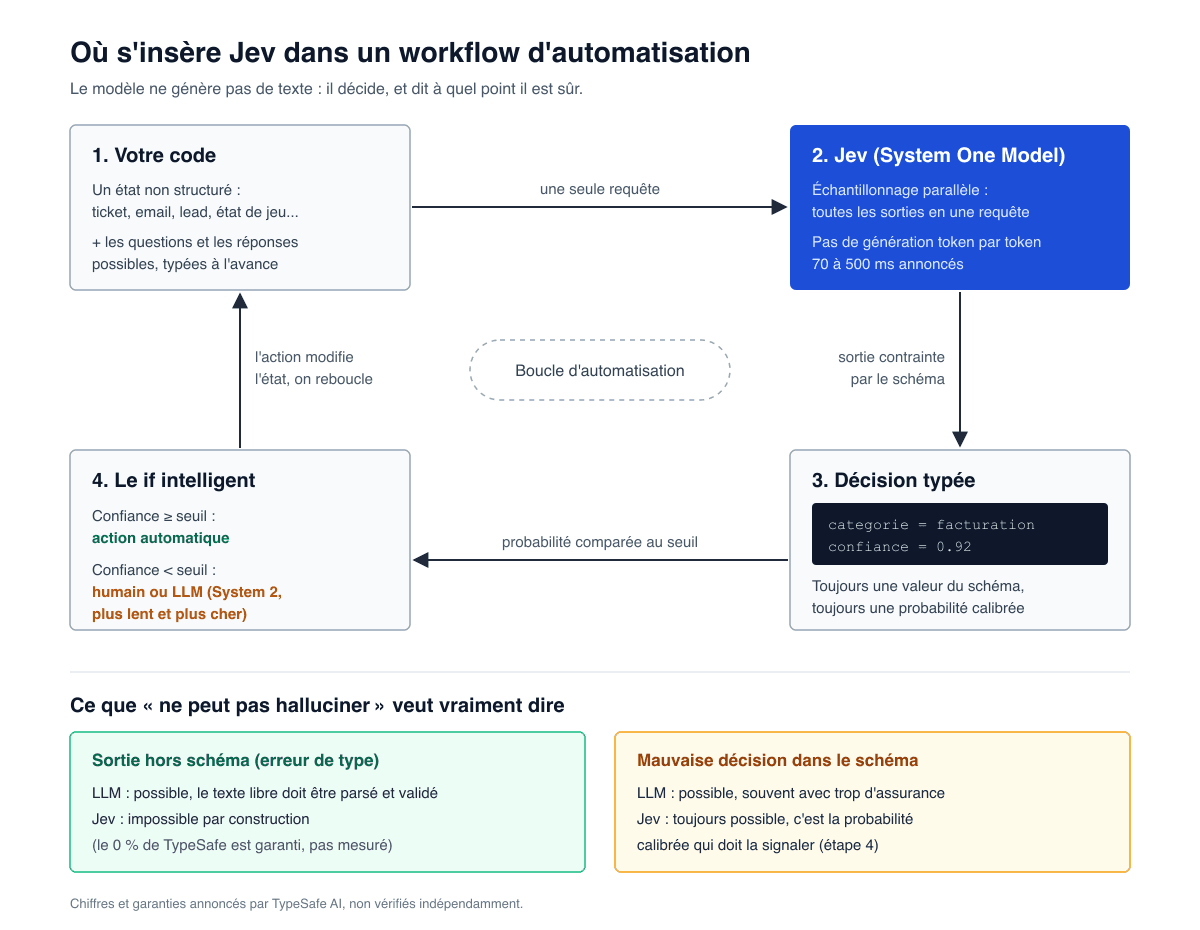
Payer un modèle frontier qui génère du texte token par token pour sortir ce qui est au fond un booléen, c'est absurde, en coût par tâche comme en latence.
Si Jev tient ses promesses en production, avec ses limites (un plafond de 255 choix possibles par décision, du texte structuré en entrée et pas encore d'images), c'est exactement la brique qui manque entre le code déterministe et l'agent qui part en roue libre.
Reste la vraie question : ces chiffres survivront-ils hors des démos lancées depuis un laptop de la côte Ouest ?

