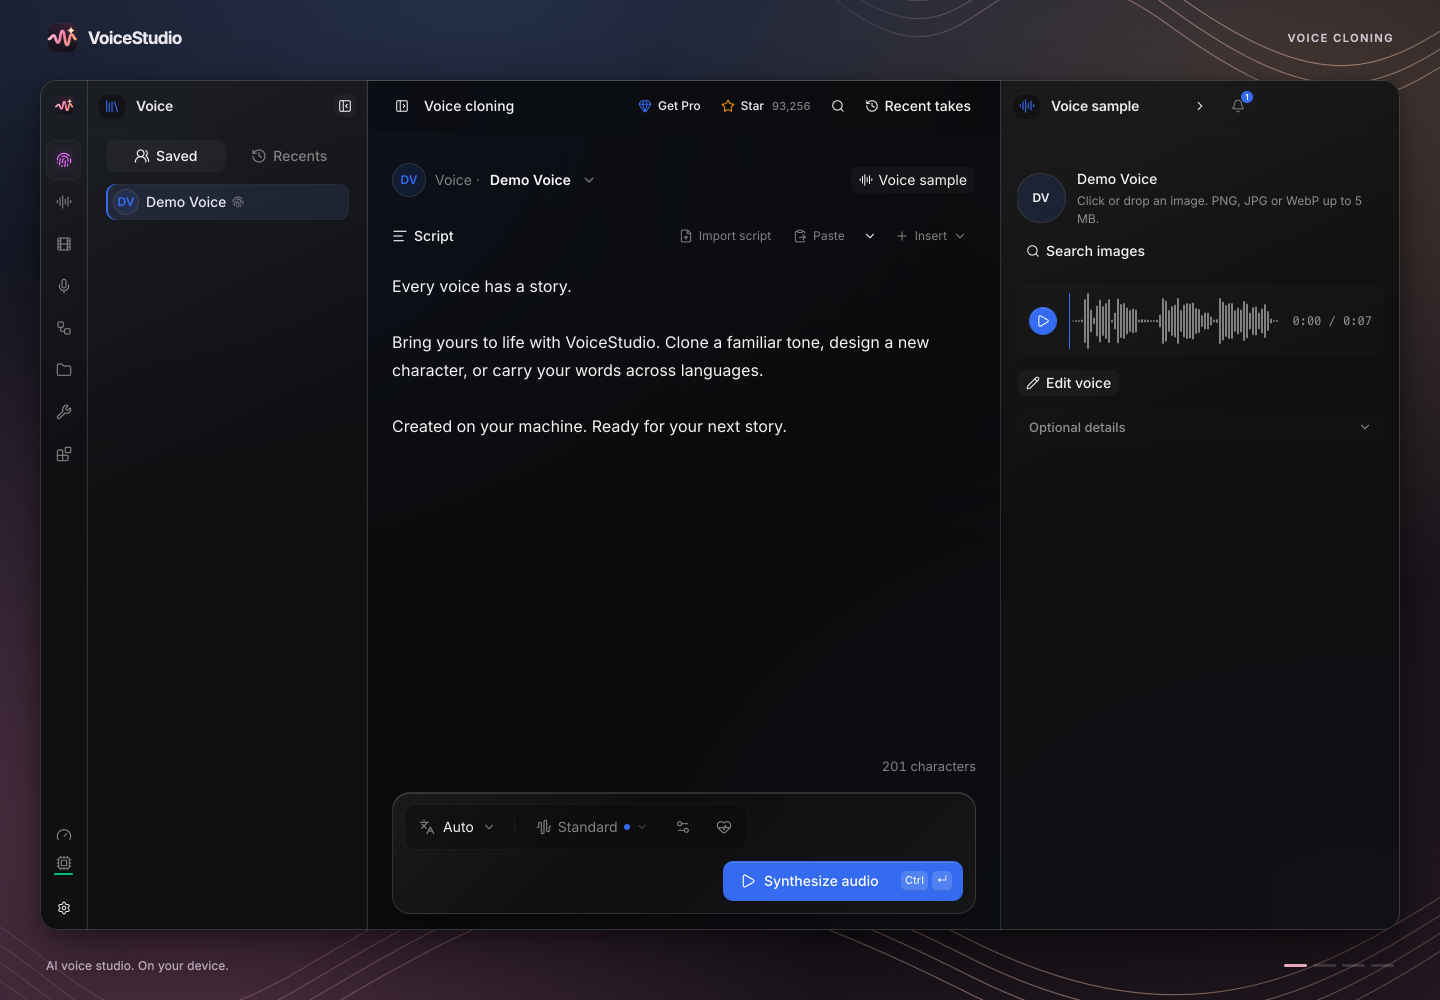
Un studio vocal local qui empile clonage, design de voix, doublage et transcription dans une seule app. Sur le papier, c'est l'ElevenLabs open source qu'on attendait. En vrai, son intérêt est ailleurs.
J'ai commencé l'IA vocale avec Bark.
Puis Chatterbox. Puis Qwen TTS.
Et entre les trois, j'ai testé à peu près tout ce qui sortait sur Hugging Face avec "TTS" ou "voice clone" dans le nom.
À chaque génération, le modèle progresse. La voix est plus naturelle, le clonage demande moins de secondes de référence, les langues se multiplient.
Mais le problème, lui, ne bouge pas.
Un modèle de voix seul ne sert à rien. Il faut le brancher à une transcription, à un découpage du texte, à une gestion de la VRAM, à un pipeline audio. Et c'est là que je passe 80 % de mon temps sur chaque projet.
C'est exactement pour ça que VoiceStudio m'intéresse.
Qu'est-ce que VoiceStudio, concrètement ?
C'est une app desktop (Electron) avec un backend Python, qui regroupe tout ce qu'on bricole d'habitude à la main :
- clonage de voix à partir d'un extrait de référence
- design de voix à partir d'une description textuelle
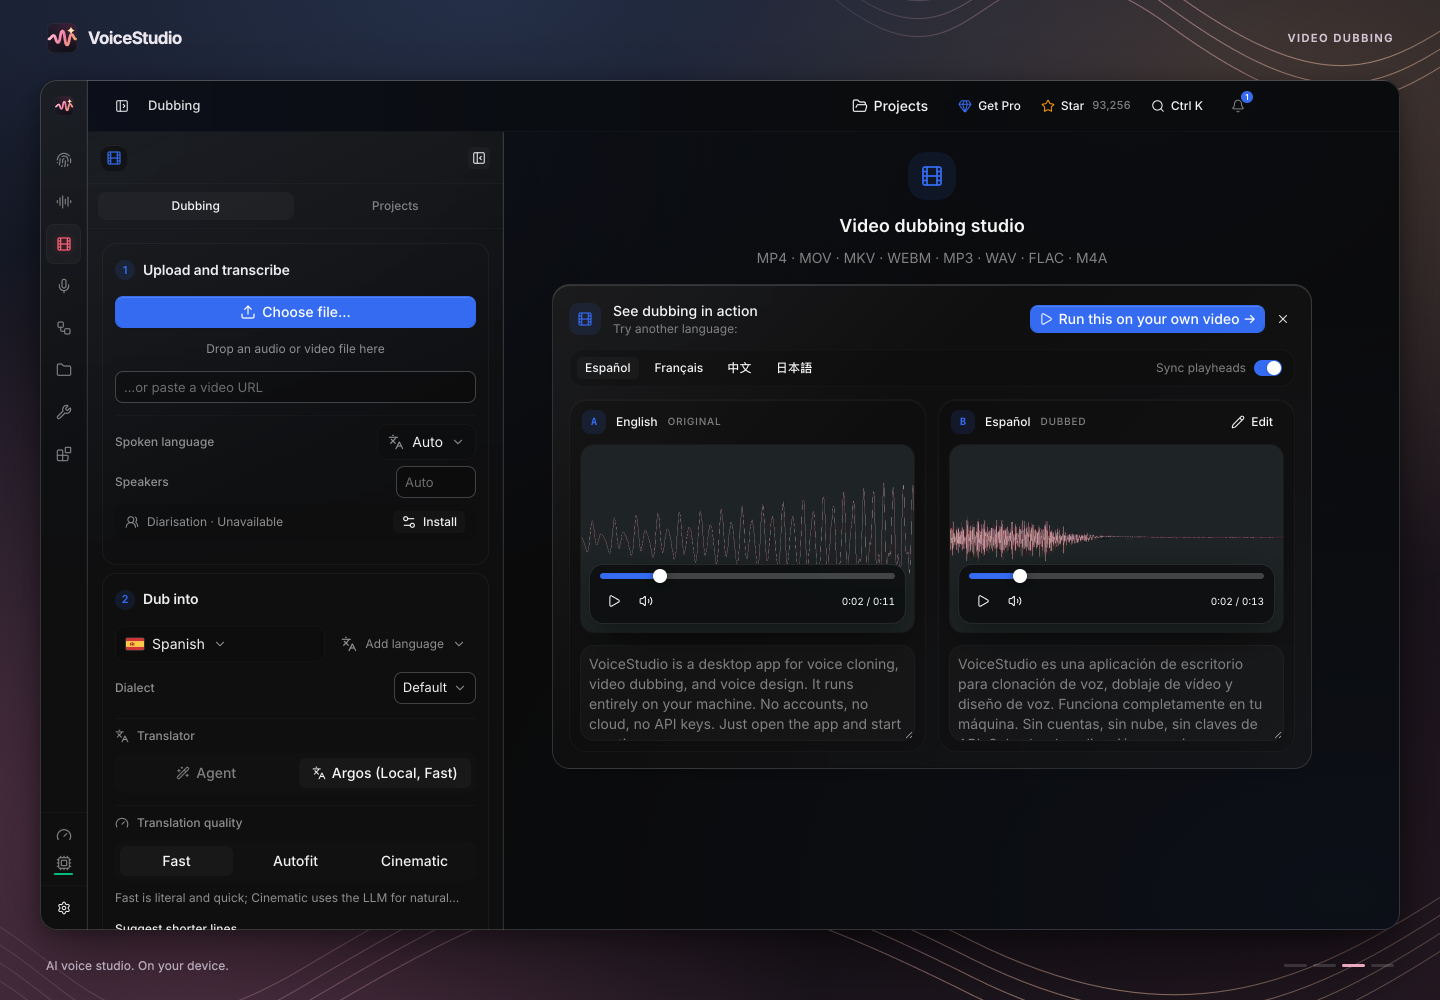
- doublage vidéo avec synchronisation sur la piste d'origine
- dictée via un widget flottant et transcription locale
- narration longue (audiobooks, histoires) avec file d'attente
- isolation vocale et diarisation des locuteurs
- API locale, serveur MCP, watch folders
Le tout tourne en local. macOS Apple Silicon, Windows, Linux et Docker sont en stable. Android et iOS sont en preview.
Le projet affiche plus de 95 000 étoiles et 6 300 commits au moment où j'écris. Ce n'est plus un side project du dimanche.
Et qu'est-ce qui génère la voix ?
Par défaut, OmniVoice, le modèle de k2-fsa (l'équipe derrière Kaldi).
C'est de là que vient le fameux "646 langues" du pitch. Et c'est un chiffre déclaré par la model card, pas un benchmark indépendant. Couvrir 646 langues et cloner proprement dans 646 langues, ce n'est pas la même promesse.
Même chose pour la vitesse : la model card annonce un RTF de 0,025 (environ 40 fois plus rapide que le temps réel). Un test tiers mesure environ 0,03 sur une RTX 4090, avec à peu près 8 Go de VRAM. Ordre de grandeur cohérent, mais sur une carte haut de gamme.
Détail qui m'amuse : selon ce même test tiers, OmniVoice serait fine-tuné à partir de Qwen3-0.6B-Base. Je n'ai pas vérifié l'info à la source, mais si c'est le cas, la boucle avec Qwen TTS est bouclée.
À côté du moteur par défaut, le Model Manager propose une quinzaine d'autres engines :
- CosyVoice 3
- IndexTTS 2.5
- VoxCPM2
- MOSS-TTS v1.5
- GPT-SoVITS
- KittenTTS, Supertonic 3, sherpa-onnx pour les petites configs
Côté transcription, WhisperX par défaut, plus Faster-Whisper, Parakeet TDT, Moonshine ou FunASR.
Ni Chatterbox, ni Bark, ni Qwen TTS dans la liste actuelle. Le casting a changé.
Mais le vrai sujet, c'est la plomberie
La valeur de VoiceStudio n'est pas dans ses modèles. Elle est dans sa doc de performance.
Je m'explique.
Quand vous lisez le fichier performance.md du repo, vous lisez la liste exacte des galères que j'ai rencontrées sur mes propres projets. Sauf qu'ici, quelqu'un les a résolues.
Quelques exemples :
- une voix clonée sans transcript de la référence force une transcription Whisper complète à chaque génération (le transcript est maintenant calculé une fois puis stocké)
- pendant un doublage, le modèle TTS est déplacé sur CPU pour laisser la VRAM à l'ASR, puis remis sur GPU (un bug laissait le modèle bloqué sur CPU après un doublage annulé, d'où des générations 10 à 50 fois plus lentes)
- un seul moteur résident en mémoire par défaut, avec un bouton Flush pour décharger sans redémarrer
- le nombre de générations parallèles est calculé selon la VRAM libre (1 worker par tranche de 5 Go, 4 max)
- un écran qui dit clairement si vous tournez sur GPU ou si vous êtes retombé sur CPU sans le savoir
La cohabitation TTS + ASR sur une seule carte, c'est le vrai mur de tout projet vocal local. Pas la qualité du modèle.
Et c'est rassurant de voir un projet qui documente ses régressions avec les numéros d'issues, plutôt que de les cacher sous un README marketing.
Donc à qui ça s'adresse ?
Pour un utilisateur lambda qui veut doubler une vidéo : installation en une ligne.
curl -fsSL https://voicestudio.sh/install | sh
L'app demande avant de télécharger chaque modèle, ce qui évite de se retrouver avec 40 Go de poids sur le disque sans l'avoir décidé.
Mais pour moi, la partie intéressante, c'est l'API locale sur le port 3900 et le serveur MCP. VoiceStudio devient une brique qu'on pilote depuis un script ou un agent :
# Ce qui est chargé en mémoire
curl "http://127.0.0.1:3900/model/loaded"

# Libérer la VRAM entre deux jobs batch
curl -X POST "http://127.0.0.1:3900/system/flush-memory?unload_model=true"
Il y a aussi une API de transcription compatible OpenAI. Donc tout outil qui sait parler à Whisper via l'API OpenAI peut basculer en local sans réécriture.
Attention à deux limites matérielles :
- sur Windows, l'accélération PyTorch est NVIDIA uniquement (ROCm existe en opt-in)
- sur Mac Intel, l'app n'est qu'une interface qui se connecte à un backend distant
Et la licence ?
L'app est sous AGPL-3.0. Usage commercial autorisé, mais si vous l'intégrez dans un service exposé en réseau, la clause réseau de l'AGPL s'applique. À lire avant de l'embarquer dans un produit client.
Les contributeurs doivent signer un CLA avant leur première PR. Classique sur les projets qui veulent garder la main sur la licence.
Et surtout : chaque modèle a sa propre licence, affichée dans le Model Manager. L'app est libre, ça ne veut pas dire que tous les poids le sont.
Côté éthique, le projet intègre un watermark IA et rappelle qu'on ne clone une voix qu'avec l'accord de son propriétaire. Ça paraît évident. Ça ne l'est pas pour tout le monde.
Alors, je l'installe ?
Oui, et je ne l'ai pas encore fait au moment où j'écris ces lignes.
Donc je ne vais pas vous dire que c'est mieux qu'ElevenLabs. Le test tiers que j'ai lu est d'ailleurs honnête là-dessus : OmniVoice gagne sur les langues, le coût et la confidentialité, pas sur la finition ni sur le streaming temps réel.
Ce que je vais regarder en priorité :
-
la qualité du clonage en français face à Qwen TTS
-
le calage du doublage sur des phrases longues
-
le comportement réel de la VRAM quand TTS et ASR tournent sur la même carte
La vraie question, au fond, ce n'est plus "quel modèle de voix choisir ?".
Les modèles tournent tous les six mois.
C'est plutôt : qui va posséder la couche d'orchestration au-dessus ? Et est-ce que ce sera un projet open source comme celui-ci, ou un SaaS qui fera payer au caractère ce qui tourne déjà sur votre GPU ?