Détection, OCR, segmentation, détourage : l'équipe vision de WeChat met tout dans un modèle de 4B. Et le plus intéressant n'est pas là où on l'attend.
Un seul modèle pour toute la chaîne de perception
WeVisOne-VL vient de sortir en open source chez Tencent, en deux tailles : 2B et 4B.
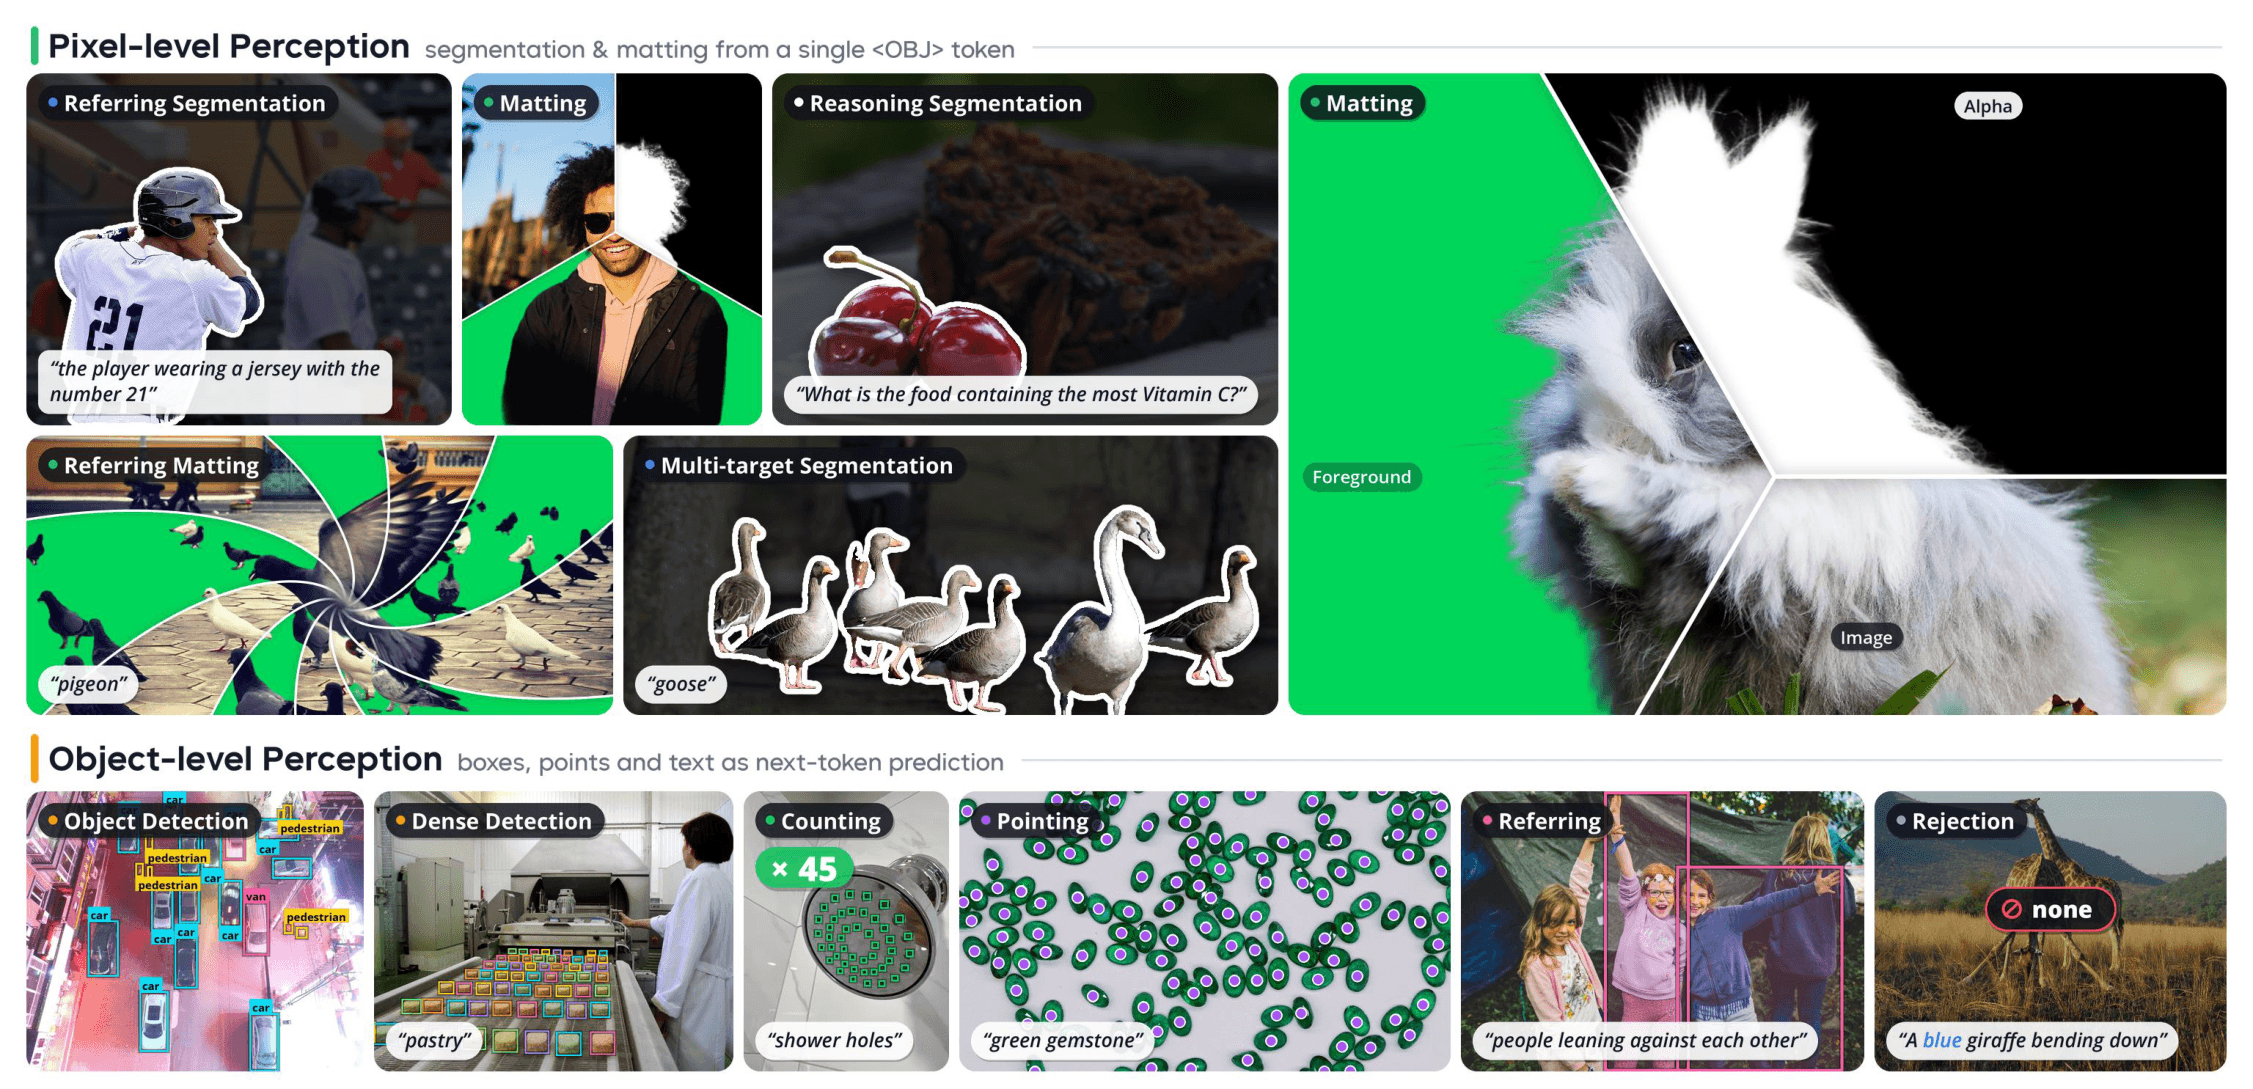
L'idée : unifier dans un seul VLM tout ce qui, aujourd'hui, demande d'empiler plusieurs briques.
- Détection open-vocabulary
- Localisation par expression ("le verre à gauche de l'assiette")
- Comptage et pointage
- OCR avec position du texte
- Segmentation en masque binaire
- Alpha matting (le détourage propre, cheveux compris)
Tout passe par de la génération de tokens structurés : coordonnées de 0 à 1000 pour les boîtes et les points, un token spécial par objet pour déclencher la sortie au pixel.
Car c'est là le choix d'archi malin : pas de SAM derrière. Un décodeur de 9,6M de paramètres récupère l'état caché de chaque objet, la boîte prédite et les features du ViT Qwen3-VL, et sort directement le masque ou l'alpha en pleine résolution.
Mais le vrai sujet, c'est le None
Quand on demande à un modèle de grounding de localiser un objet absent de l'image, la plupart en inventent un. Sur le split de rejet de RefCOCOg, Rex-Omni-3B rejette 0,5 % des requêtes pièges, LocateAnything-3B 0,6 %. Autrement dit, ils hallucinent quasi systématiquement.
WeVisOne-VL-4B monte à 67,4 % sur ce même test, et à 96,4 % sur WeRef-Bench (leur propre benchmark, je le note).
En prod, un modèle qui trouve un "extincteur" sur une photo où il n'y en a pas, c'est pire qu'un modèle un peu moins précis. Tout le pipeline en aval part sur une donnée fausse. Savoir répondre None, c'est ce qui rend un modèle de vision exploitable dans un process automatisé.
Côté chiffres, le reste suit :
- LVIS : 55,3 contre 50,7 pour la meilleure baseline
- OCR TotalText : 52,0 contre 43,3
- Matting par texte : erreur MAD de 9,8 contre 22,4 pour Qwen3.5-9B + SAM2-Matting
Donc, ça tourne où ?
Le code Tencent est sous Apache 2.0 (les composants tiers gardent leur licence, à vérifier selon votre usage). Les poids 2B et 4B sont sur Hugging Face.
L'utilisation est volontairement simple :
from PIL import Image
from wevisone_vl import WeVisOneVL

model = WeVisOneVL("tencent/WeVisOne-VL-4B", backend="vllm")  # ou "transformers"

image = Image.open("photo.jpg").convert("RGB")
result = model.predict(image, task="matting", query="person")
Deux backends (transformers et vLLM), une démo Gradio, des notebooks par type de tâche. Et un détail qui m'intéresse directement : le device "npu" est supporté en plus de CUDA et du CPU. Pour ceux qui, comme moi, font tourner de l'inférence sur Ascend, c'est rarement le cas sur ce genre de release.
En bonus, l'équipe a aussi publié Mask2Alpha, l'outil qui transforme des masques binaires en alpha mattes et qui a servi à annoter leur dataset (plus de 100M d'images via leur data engine).
Ce qui manque encore : le code de fine-tuning, toujours dans la TODO.