GitHub vient de reconstruire son API d'historique des stars. Et derrière l'annonce produit, il y a surtout une leçon SQL que beaucoup de devs n'ont toujours pas intégrée.
2 511 requêtes pour tracer une simple courbe
Pour afficher la courbe de stars d'un repo, des outils comme star-history.com n'avaient qu'une option : paginer l'endpoint stargazers, 100 utilisateurs par page, garder les dates et jeter les identités.
Pour react/react et ses 251 000 stars, ça donnait environ 2 511 requêtes.
Et ce n'était que la partie visible du problème :
- les listes de stargazers étaient scrapées en masse pour alimenter des campagnes de spam et de phishing
- un bug de pagination faisait compter toutes les stars du repo à chaque requête, juste pour calculer le nombre de pages
- sur une seule semaine, près de 37 000 de ces COUNT ont été loggés comme lents (environ 3 secondes en moyenne), et plus de 1 000 ont été tués par les garde-fous de la base
Je trouve ce dernier point savoureux.
Un COUNT(*) sur toute la table à chaque page, c'est le genre d'erreur que je vois dans des back-offices de PME. Pas chez GitHub.
Mais LIMIT ne rend pas la requête moins chère
L'idée évidente, c'était de renvoyer des agrégats plutôt que des personnes : grouper les stars par jour, trier, paginer avec LIMIT et OFFSET.
Sauf que ça ne change quasiment rien au coût. Je m'explique.
En SQL, l'ordre logique d'exécution n'est pas l'ordre dans lequel vous écrivez la requête :
- FROM et WHERE : la base sélectionne les lignes
- GROUP BY : elle construit tous les groupes
- ORDER BY : elle trie tous les groupes
- LIMIT / OFFSET : elle découpe le résultat
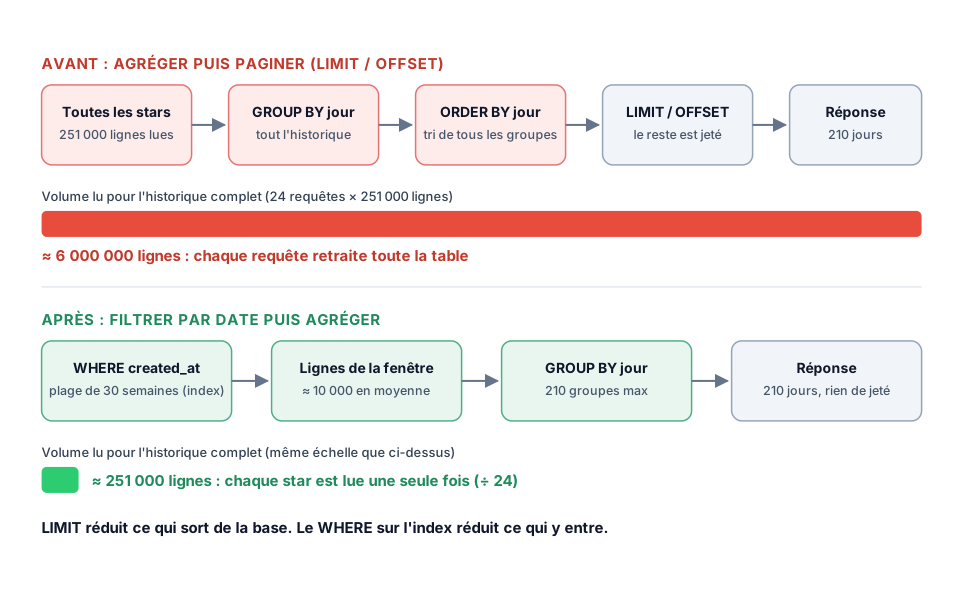
LIMIT arrive en dernier. Il réduit ce que vous recevez, pas ce que la base a traité.
Et dès qu'il y a un GROUP BY suivi d'un ORDER BY sur l'agrégat, le moteur ne peut pas s'arrêter en route : il doit avoir tous les groupes en main pour savoir lesquels sont les 7 premiers.
OFFSET aggrave le tout, car les lignes sautées sont quand même lues, puis jetées.
-- Version naïve : toutes les stars du repo sont lues, groupées et triées
-- avant que LIMIT ne garde 7 lignes
SELECT DATE(created_at) AS jour, COUNT(*) AS stars
FROM stars
WHERE repository_id = :repo_id
GROUP BY jour
ORDER BY jour DESC
LIMIT 7 OFFSET 210;

-- Version GitHub : le filtre temporel sur un index (repository_id, created_at)
-- réduit les lignes AVANT l'agrégation
SELECT DATE(created_at) AS jour, COUNT(*) AS stars
FROM stars
WHERE repository_id = :repo_id
  AND created_at >= :debut_fenetre
  AND created_at < :fin_fenetre
GROUP BY jour
ORDER BY jour;
Petite nuance quand même : un LIMIT peut être très efficace quand le tri suit un index et qu'il n'y a aucune agrégation. Le moteur lit l'index dans l'ordre et s'arrête après N lignes.
Mais dès que vous groupez ou triez sur une valeur calculée, cette sortie anticipée disparaît.
Résultat côté GitHub : avec l'approche agrégat + LIMIT, lire tout l'historique de react/react en 24 requêtes aurait coûté environ 6 millions de lignes examinées. Chaque requête retraitait les 251 000 stars.
Donc on filtre avant de compter
La version livrée pagine par semaines calendaires. Chaque page est traduite en plage de dates sur created_at, indexée, et la base ne groupe que les lignes de cette plage.
Les chiffres parlent d'eux-mêmes :
- jusqu'à 30 semaines de comptes quotidiens par requête
- environ 24 requêtes pour react/react au lieu de 2 511
- environ 251 000 lignes lues au total, soit chaque star lue une seule fois
- plus aucune identité dans la réponse
Et en creusant, ils ont trouvé le même anti-pattern sur la page stargazers de github.com. Passée sur le compteur en cache, elle est descendue de plusieurs centaines de requêtes lentes par semaine à zéro.
C'est exactement la logique du keyset pagination : vous ne demandez pas "la page 30", vous demandez "ce qui se trouve entre telle et telle borne". L'index fait le travail, la base ne lit que ce dont elle a besoin.