Dernièrement je vous parlais de Jev de Typesafe.
Ils ont proposé une approche différente de l'IA, moins couteuse en énergie, plus réactive.
Mais le but n'est pas du tout le même.
Jev est une solution qui ne cherche pas à faire une conversation avec vous, cette étape qui demande justement beaucoup de ressource.
A la différence, Jev propose de vous renvoyer un JSON avec une probabilité:
Voici un exemple d'utilisation:
/**
 * Exemple minimal : passer les données d'un prospect à Jev et récupérer
 * une probabilité "va acheter".
 *
 * npm install @typesafe-ai/sdk      # Node >= 20
 * export TYPESAFE_API_KEY=...
 * npx tsx jev-prospect-score.ts
 */
import { noul, score, TypeSafeClient, TypeSafeError } from '@typesafe-ai/sdk'

const client = new TypeSafeClient({ defaultModel: 'jev-1.13.0' }) // version pinnée pour des seuils stables

interface Prospect {
  company: string
  size: string
  sector: string
  contact_role: string
  last_email: string
  interactions: string
}

// Uniquement ce dont les questions ont besoin (Jev souffre du context rot)
const prospect: Prospect = {
  company: 'Menuiserie Lacoste SARL',
  size: '18 salariés',
  sector: 'Artisanat / BTP',
  contact_role: 'Gérant',
  last_email:
    'On perd un temps fou à ressaisir les devis dans Sage. ' +
    'Si vous pouvez automatiser ça, on a un budget prévu pour Q1. ' +
    'Dispo pour un call la semaine prochaine ?',
  interactions: '2 emails échangés, 1 visite de la page tarifs',
}

const offer = "Automatisation de la saisie des devis vers l'ERP, forfait 4 500 € HT"

// Toutes les questions dans un seul appel (fan-out), évaluées en parallèle
const QUESTIONS = {
  // La question directe
  will_buy: noul('Given `prospect`, will this prospect purchase `offer` within the next 3 months?', {
    true: 'Explicit need matching the offer, budget or timeline mentioned, contact can decide',
    false: 'No concrete need, no budget, or contact has no decision power',
  }),
  // Signaux vérifiables : plus fiables qu'un jugement global
  decision_maker: noul('Is `prospect.contact_role` someone who can sign a purchase for the company?'),
  budget_mentioned: noul('Does `prospect.last_email` mention an available budget or a spending timeframe?'),
  pain_fit: score('How well does the problem in `prospect.last_email` match `offer`?', [
    'No problem described, or unrelated to the offer',
    'Related problem, but the offer only partially solves it',
    'The described problem is exactly what the offer solves',
  ]),
}

const PAIN_FIT_MAX = 2 // 3 niveaux → score de 0 à 2

type Tier = 'hot' | 'warm' | 'cold'

interface ProspectScore {
  model: string
  willBuy: number
  composite: number
  tier: Tier
}

export async function scoreProspect(p: Prospect, o: string): Promise<ProspectScore> {
  const { answers, model } = await client.systemOne({
    state: { prospect: p, offer: o },
    questions: QUESTIONS,
  })

  // Réponses typées par le SDK : .noul pour noul, .score/.confidence pour score
  const { will_buy, decision_maker, budget_mentioned, pain_fit } = answers

  // Score composite : les poids sont à toi, pas au modèle
  const composite =
    0.35 * decision_maker.noul +
    0.25 * budget_mentioned.noul +
    0.4 * (pain_fit.score / PAIN_FIT_MAX)

  const tier: Tier = will_buy.noul > 0.8 ? 'hot' : will_buy.noul > 0.4 ? 'warm' : 'cold'

  console.table({
    will_buy: will_buy.noul,
    decision_maker: decision_maker.noul,
    budget_mentioned: budget_mentioned.noul,
    pain_fit: pain_fit.score,
    pain_fit_confidence: pain_fit.confidence,
    composite,
  })

  return { model, willBuy: will_buy.noul, composite, tier }
}

try {
  const result = await scoreProspect(prospect, offer)
  console.log(result) // loguer `model` avec chaque décision
} catch (error) {
  // 401 clé, 422 validation, 429/529 déjà retentés par le SDK
  if (error instanceof TypeSafeError) {
    console.error(`Jev failed: ${error.message}`)
    process.exit(1)
  }
  throw error
}
Ce qui est intéressant surtout c'est une approche où on n'a pas besoin de mouliner une réponse sous forme de paragraphe. Il va compute, calculer ses probabilités par rapport à ses poids et répondre.
Oui, il y a une marge d'erreur (c'est comme tout en IA). Mais le gain en temps de réponse et en coût est colossal.
Là vous aurez une réponse en milliseconde et ça ne vous coutera même pas 1 centime vs plusieurs secondes et plusieurs centimes parfois avec certains modèles.
Qu'est-ce que j'ai fait avec Jev ?
J'utilisais un petit modèle pour faire passer des conditions sur les workflows N8N d'un de mes Bots. Il est censé faire de la veille technologique pour moi.
Et une simple vérification de si l'information était importante pour moi et nouvelle me coutait environ 20 centimes par jour avec Haiku, le plus petit modèle d'Anthropic.
J'ai passé à Jev et le workflow s'exécute toujours autant de fois chaque jour, observez les prix sur mes dépenses API Claude:
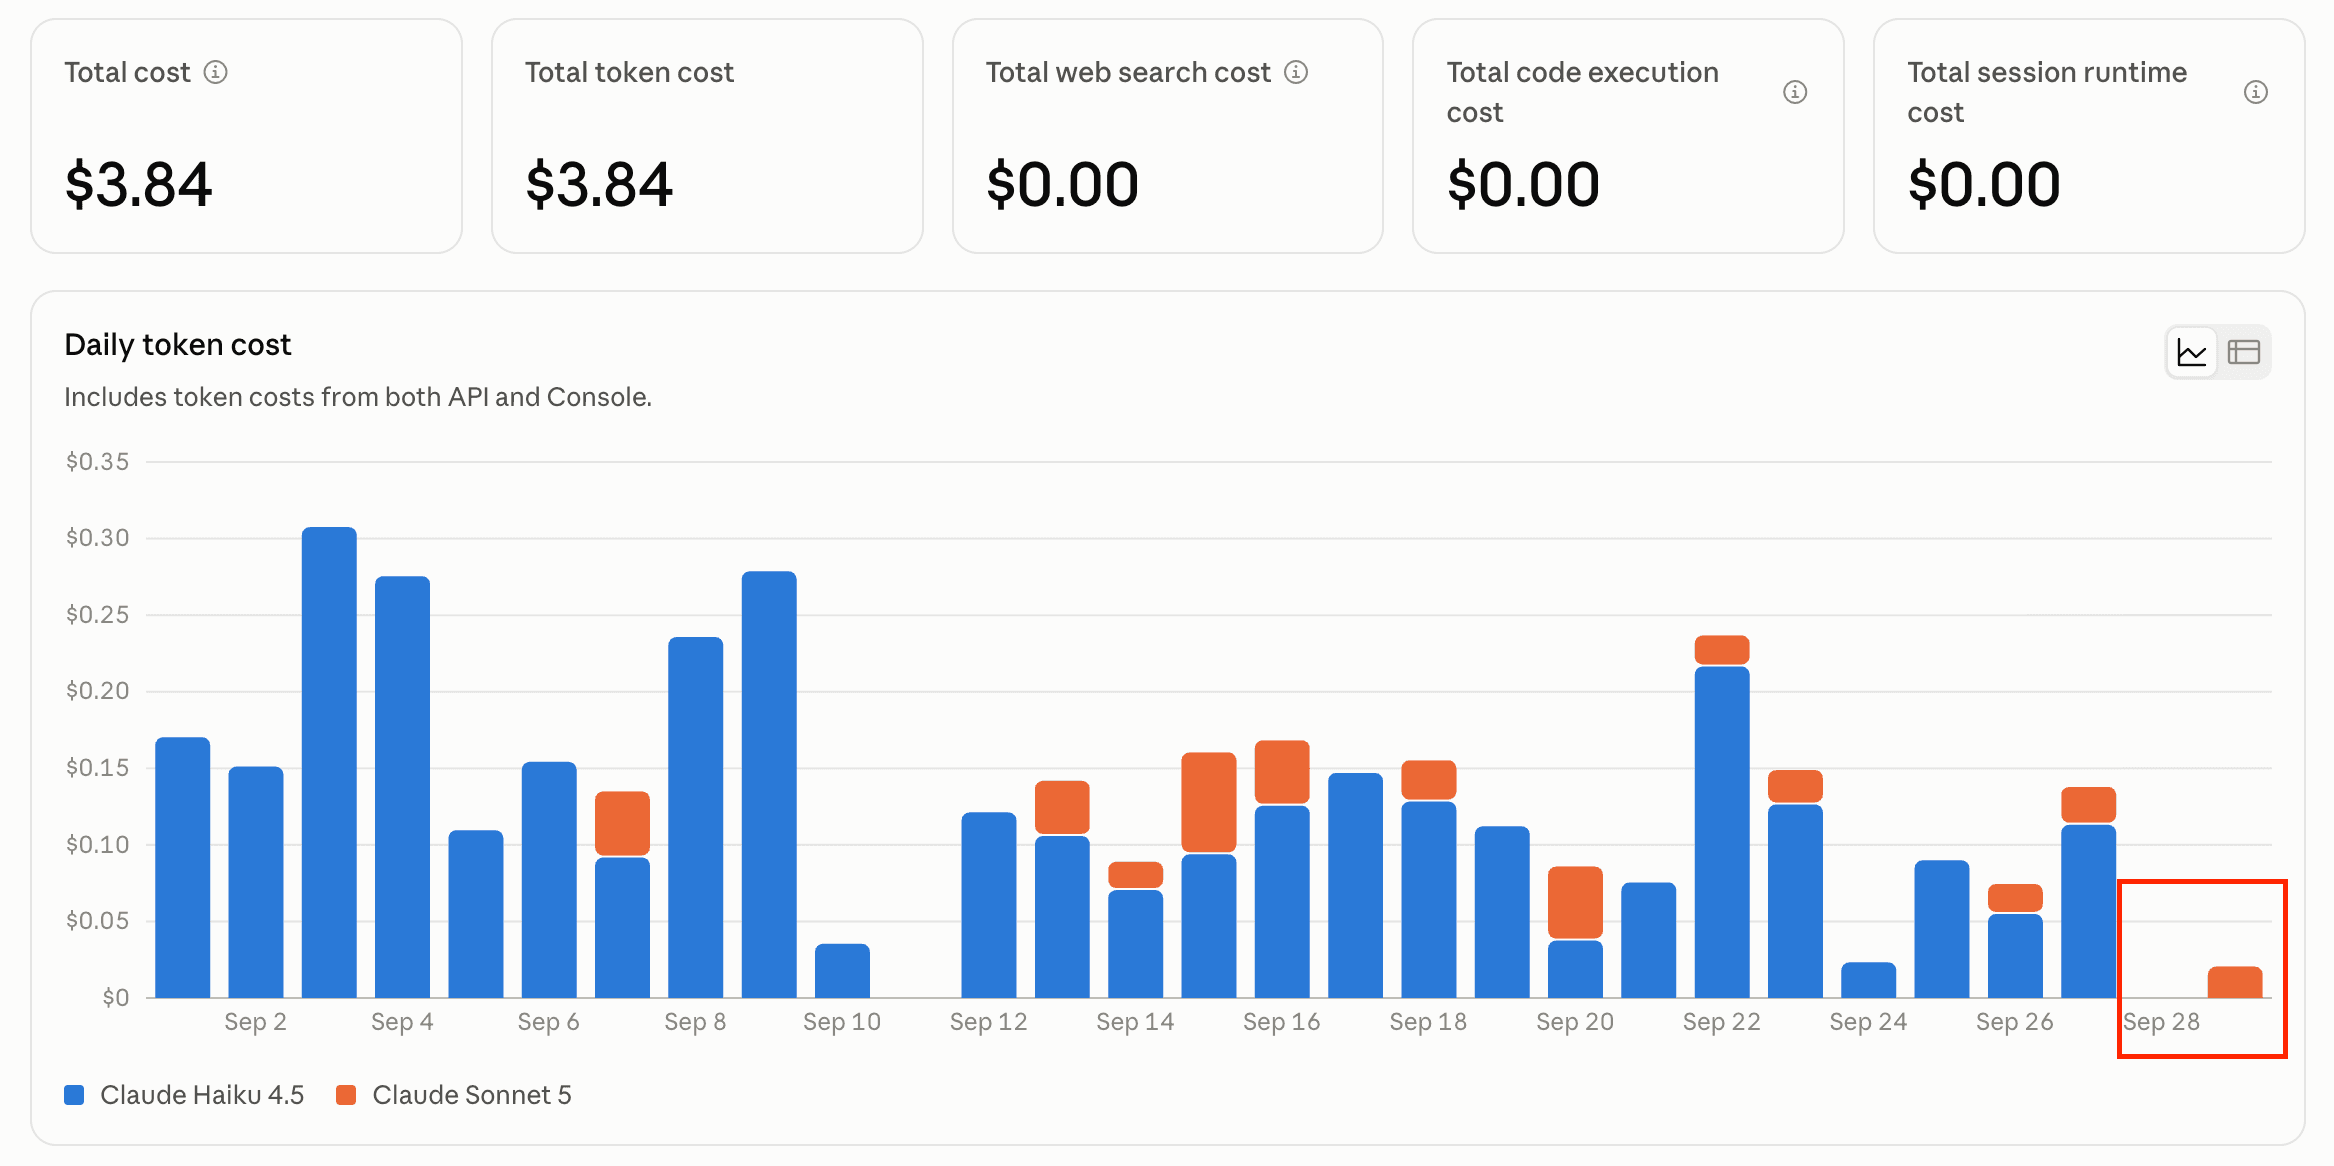
Comme on peut le voir, il n'y a plus d'appel Haiku, ça c'est normal.
Mais surtout en contre partie en utilisant Jev à combien je suis passé ?
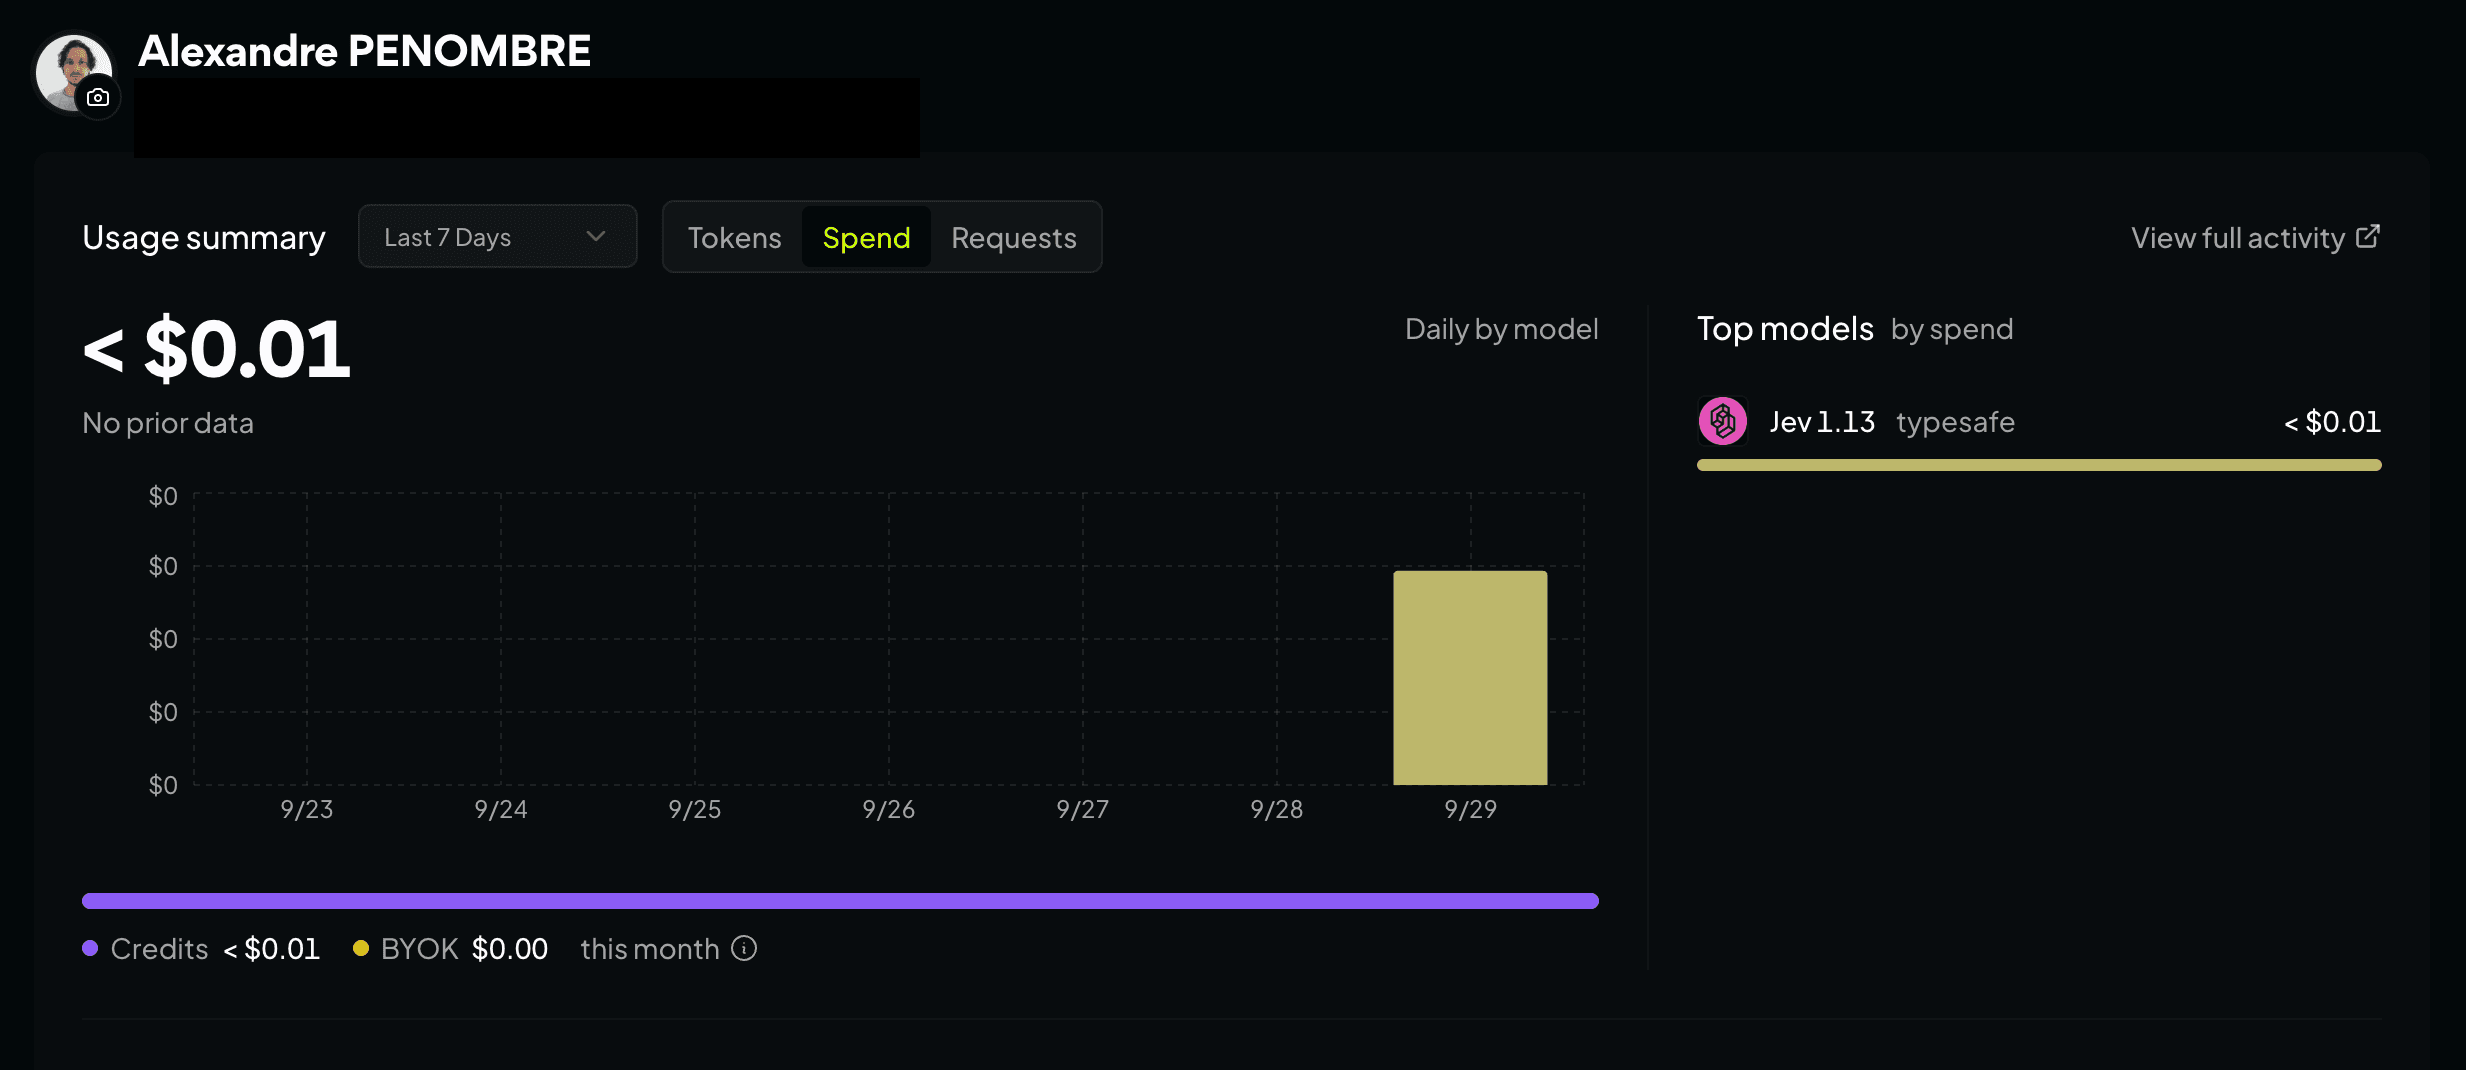
J'ai eu beau l'appeler plusieurs fois, je suis toujours à 1 centime de dépense pour le moment (> 24h après).
Et pour autant, mon bot m'envoie toujours des alertes:
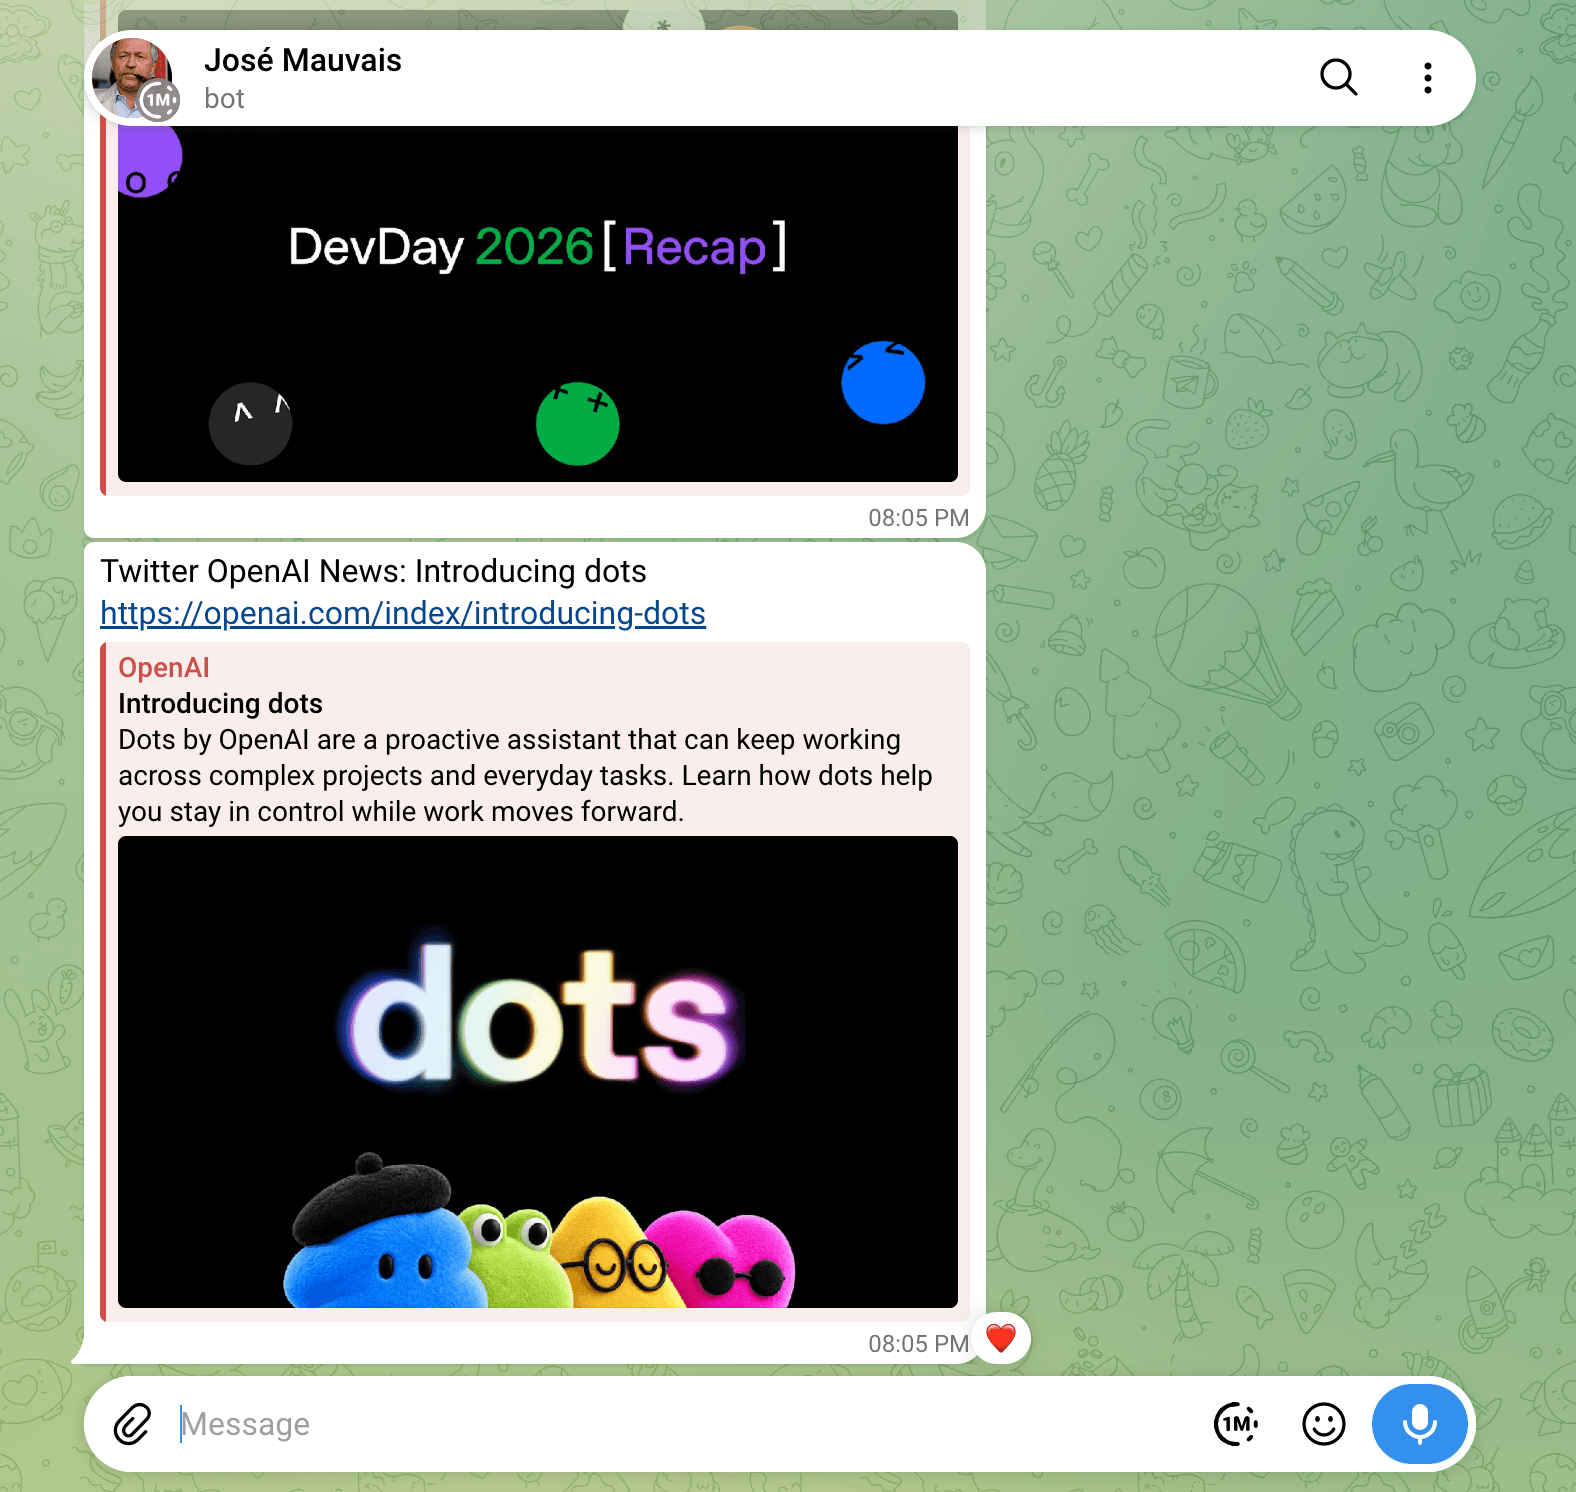
J'ai donc réduit mes dépenses de 20 fois environ...
Merci Jev !